Wszystkie notatki

Archiwum aionprem.pl. Najnowsze u góry.

32 notatki
Kalkulator TCO AI: 4 gotowe scenariusze chmura vs on-prem
[vendor-eval]

Nie musisz liczyć TCO od zera. Cztery gotowe profile firm, od pilotażu po obłożenie 24/7, przeliczone tymi samymi stawkami na 3 lata: managed API vs wynajem GPU vs on-prem. Rozpoznaj swój scenariusz, zobacz werdykt i dźwignię, która go przewraca.
vLLM czy TensorRT-LLM: który silnik do on-prem LLM
[architektura]

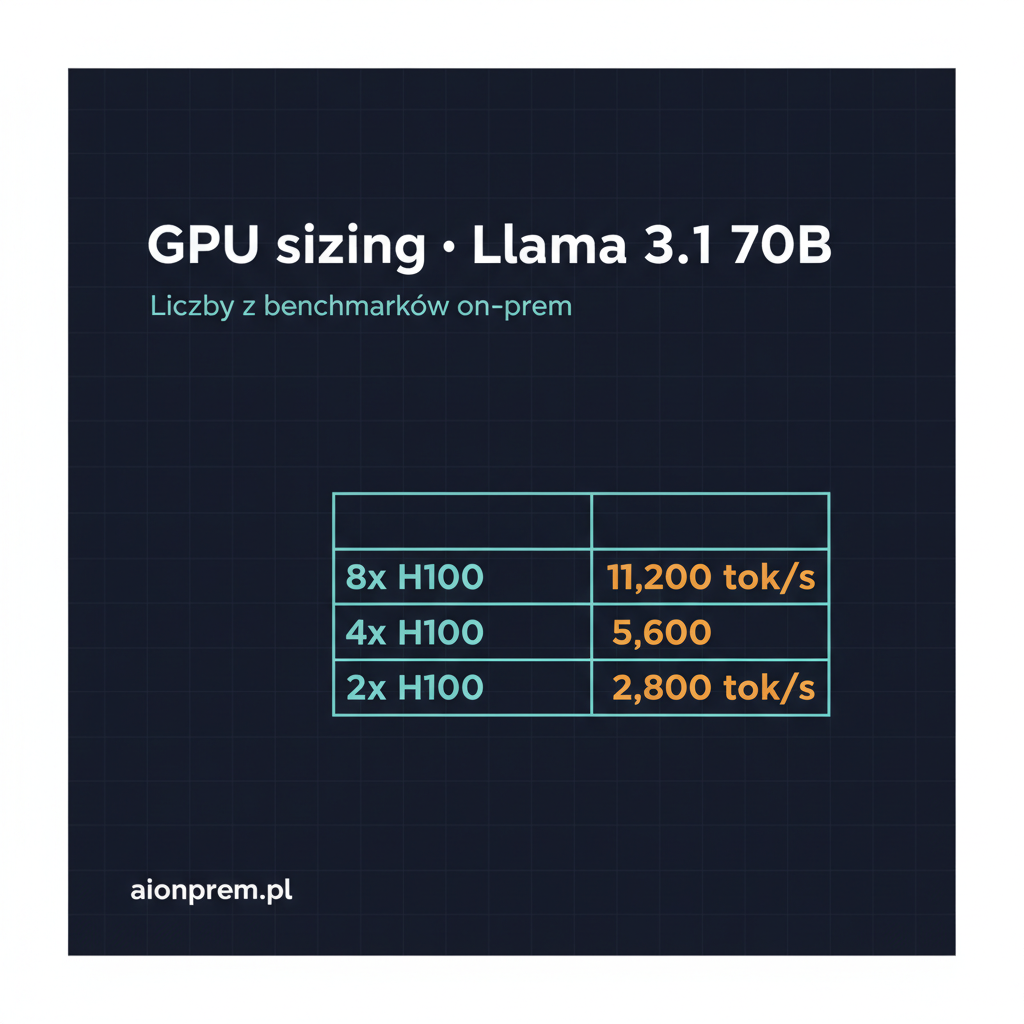
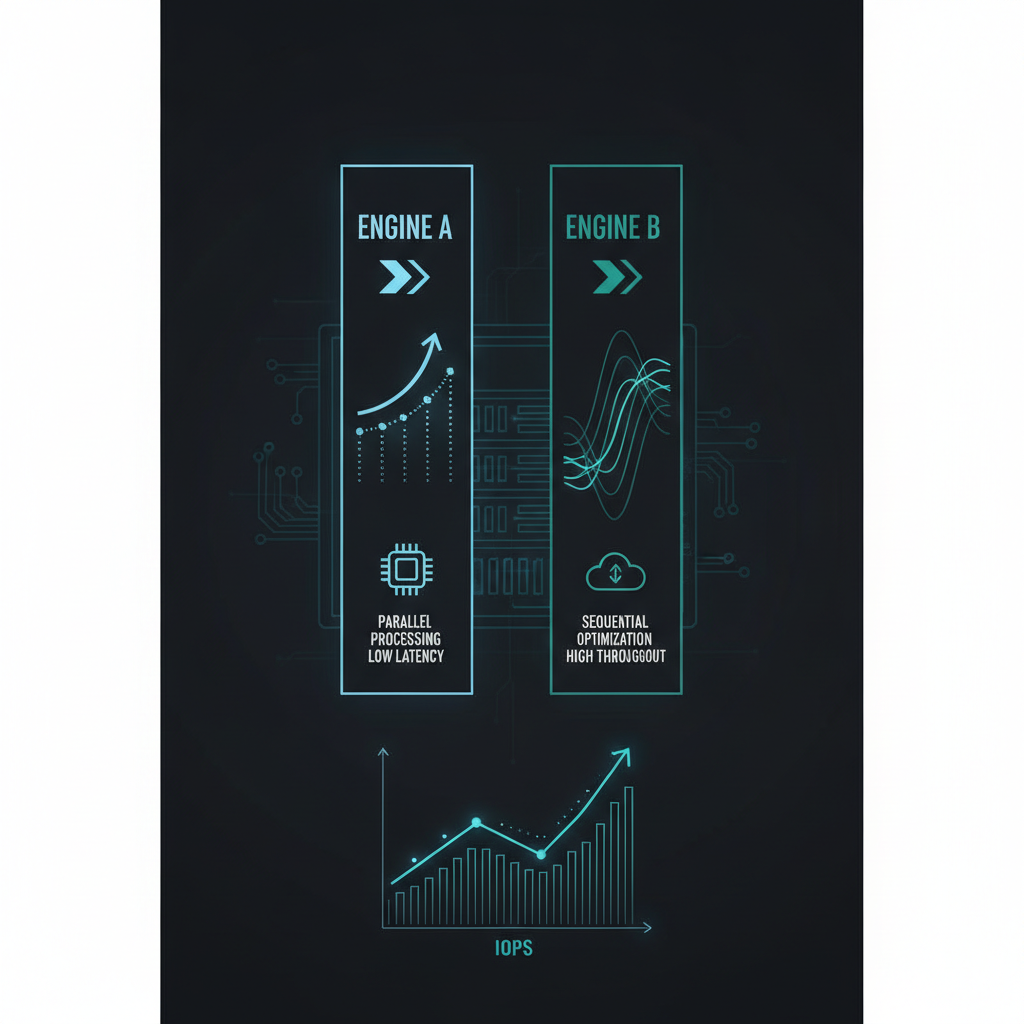
Sizing GPU odpowiada, ile kart kupić. Wybór silnika serwującego decyduje, ile z nich wyciśniesz. Porównanie vLLM i TensorRT-LLM (plus SGLang) na Llama 70B: throughput, TTFT, koszt kompilacji i tabela decyzyjna, który wybrać do on-prem.

Dobór GPU i kwantyzacja LLM, gdy H200 jest niedostępny
[on-prem]

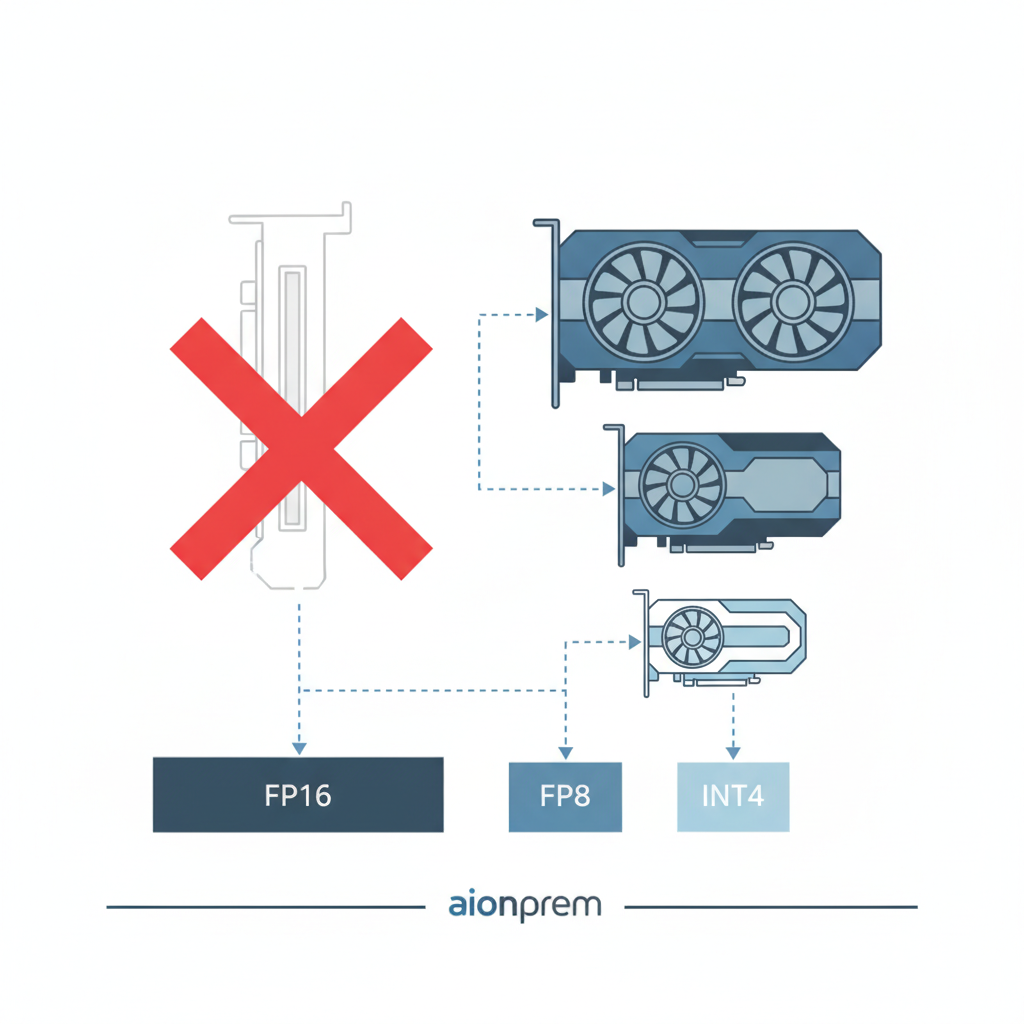
H200 rzadko przychodzi od ręki, a decyzja o wdrożeniu nie czeka na dostawę. Rozkładamy dobór GPU pod model klasy 70B od strony dostępności: ile pamięci zjada model w każdej precyzji, na czym mieści się po kwantyzacji do FP8 i INT4, którą kartę wziąć zamiast H200 i czym za to płacisz.

Ile kosztuje milion tokenów on-prem: H100 vs H200 vs API
[architektura]

Peak throughput z benchmarku nie mówi, ile kosztuje milion tokenów. Rachunek to stawka za godzinę karty podzielona przez tokeny na godzinę i przez obłożenie. Liczymy koszt per milion tokenów na H100 i H200, zestawiamy z ceną API i pokazujemy próg obłożenia, powyżej którego on-prem wygrywa.

Public cloud LLM a NIS2: szybka analiza Art. 21 ust. 1 lit. d
[nis2]

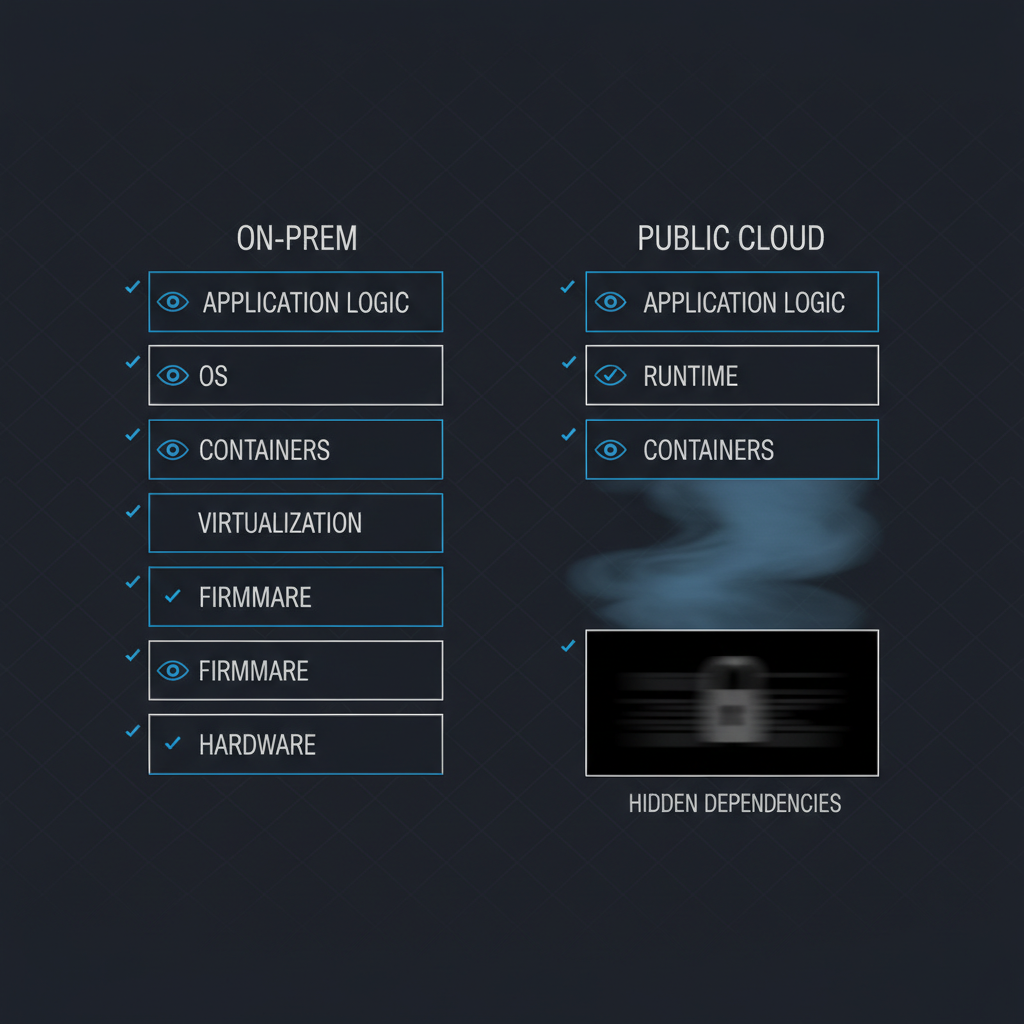
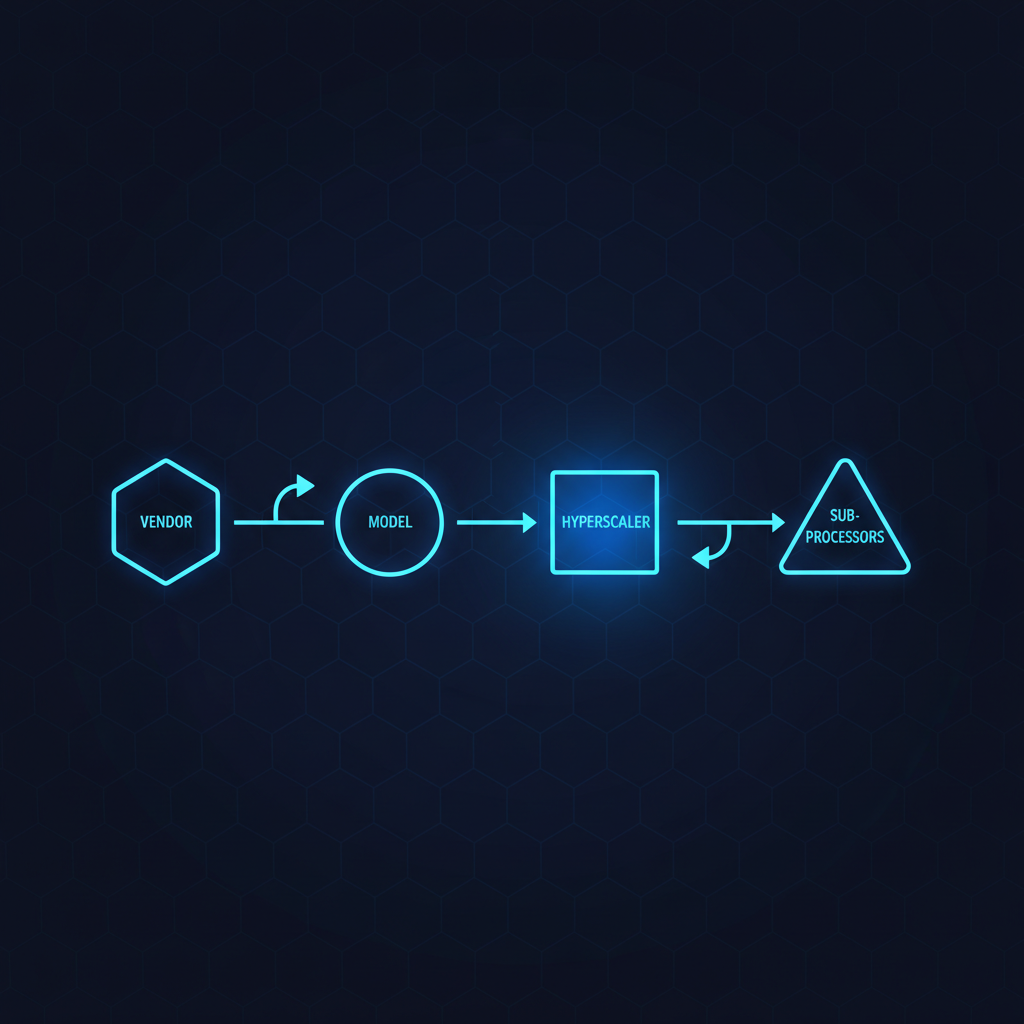
Notatka techniczna: jeden artykuł NIS2 i jeden scenariusz. Czy umowa z ChatGPT Enterprise lub Claude spełnia Art. 21 ust. 1 lit. d? Trzy obszary, w których standardowa relacja z public cloud LLM zaczyna się rozjeżdżać z wymaganiami compliance łańcucha dostaw.