Klaster tematyczny

Architektura on-prem AI: RAG, GPU sizing, benchmarki

Szybka odpowiedź

Warstwa techniczna wdrożenia on-prem AI: jak zbudować RAG, który nie halucynuje, jak dobrać GPU pod model i obciążenie oraz jak mierzyć jakość retrievalu i przepustowość inferencji. Konkrety, benchmarki i architektury referencyjne zamiast diagramów marketingowych.

Architektura on-prem AI: RAG, GPU sizing, benchmarki

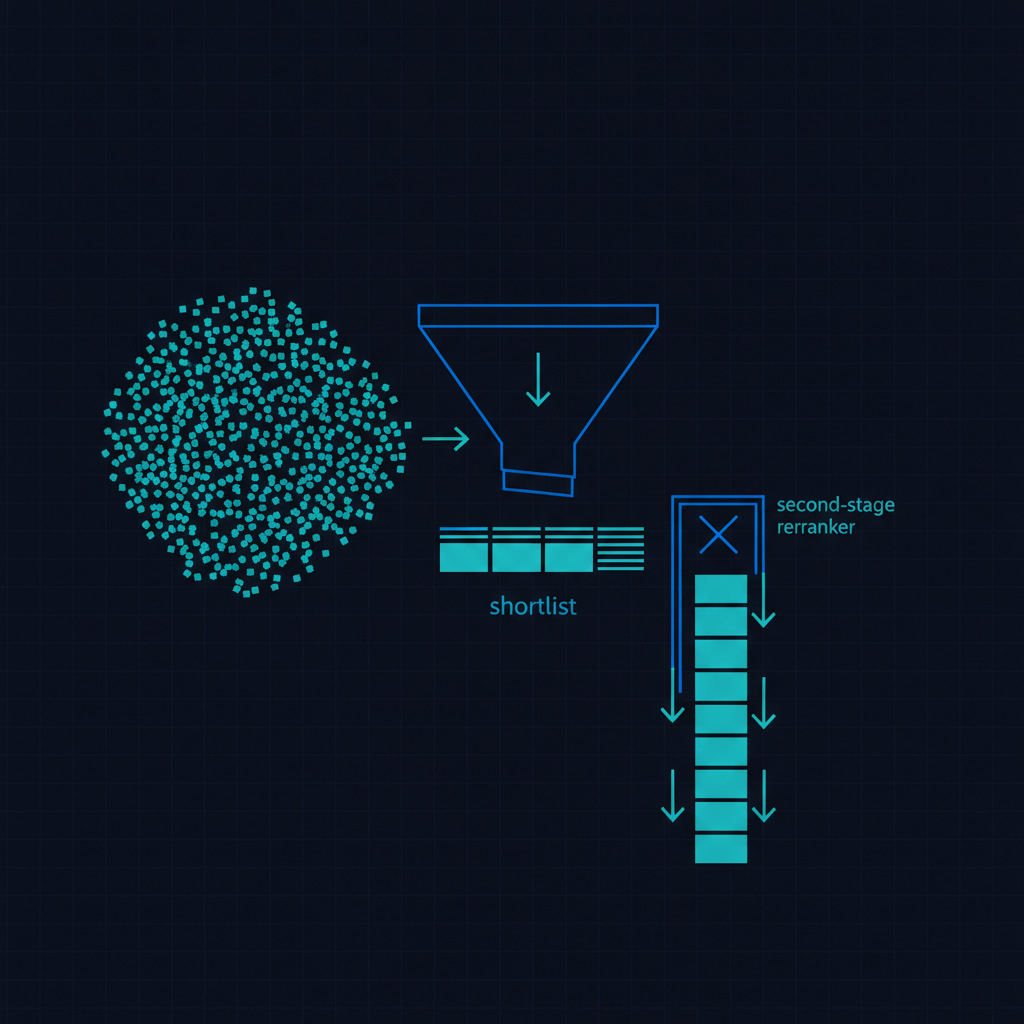
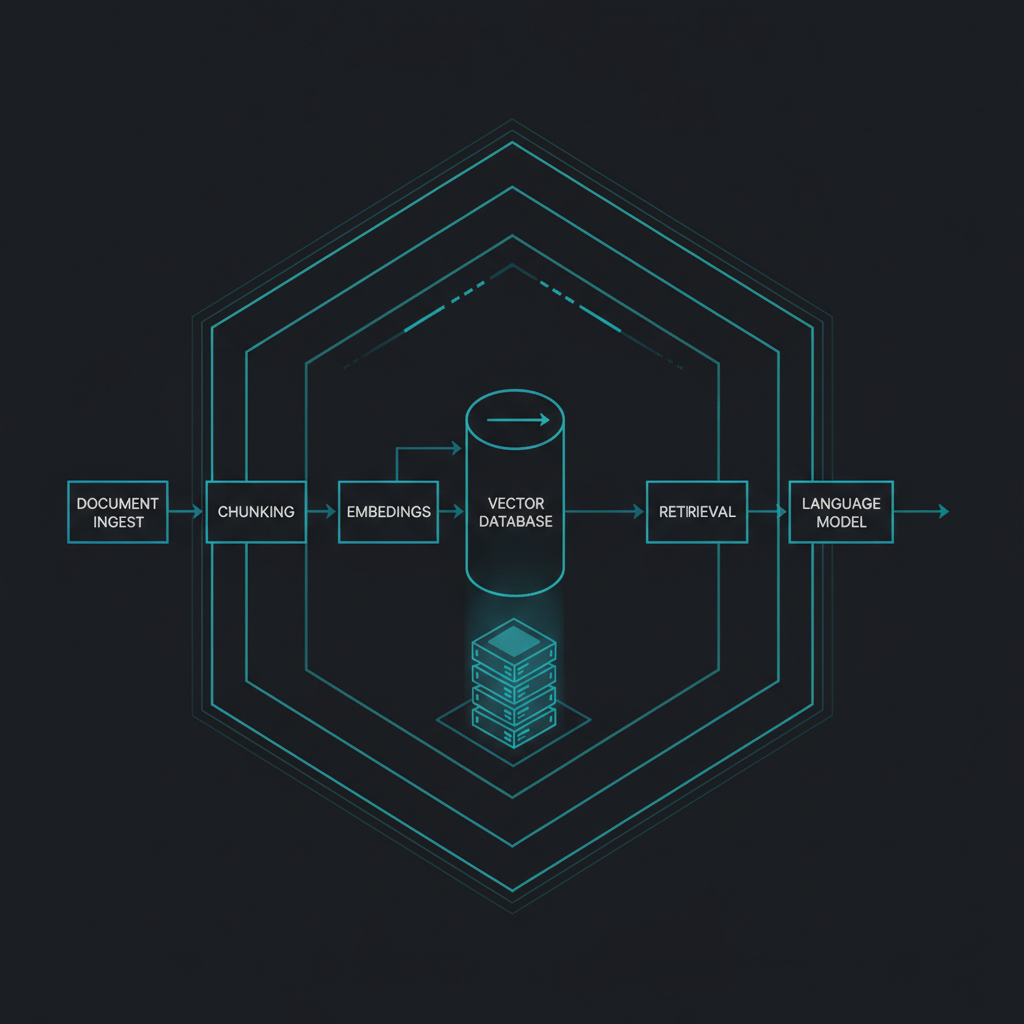
Ten klaster to inżynierska strona on-prem AI. Rozkładamy pipeline RAG na części, które realnie decydują o jakości: chunking, embeddingi, retrieval i reranking, z odpowiedzią, kiedy reranker (cross-encoder) poprawia trafność, a kiedy tylko zjada budżet GPU. Publikujemy GPU sizing na liczbach (np. Llama 70B: throughput, VRAM, kwantyzacja, vLLM/TensorRT-LLM) i architektury referencyjne mapowane na wymogi bezpieczeństwa. To materiał dla CIO i architektów, którzy muszą podjąć decyzje sprzętowe i projektowe, a nie znajdują w polskim internecie neutralnych benchmarków, bo te są niemal wyłącznie po angielsku. Każdy artykuł techniczny łączymy z konsekwencją regulacyjną (logowanie, izolacja, nadzór) i z kalkulatorem TCO, żeby decyzja architektoniczna miała cenę.

// notatki w tym klastrze (7)
vLLM czy TensorRT-LLM: który silnik do on-prem LLM

Sizing GPU odpowiada, ile kart kupić. Wybór silnika serwującego decyduje, ile z nich wyciśniesz. Porównanie vLLM i TensorRT-LLM (plus SGLang) na Llama 70B: throughput, TTFT, koszt kompilacji i tabela decyzyjna, który wybrać do on-prem.
Ile kosztuje milion tokenów on-prem: H100 vs H200 vs API

Peak throughput z benchmarku nie mówi, ile kosztuje milion tokenów. Rachunek to stawka za godzinę karty podzielona przez tokeny na godzinę i przez obłożenie. Liczymy koszt per milion tokenów na H100 i H200, zestawiamy z ceną API i pokazujemy próg obłożenia, powyżej którego on-prem wygrywa.

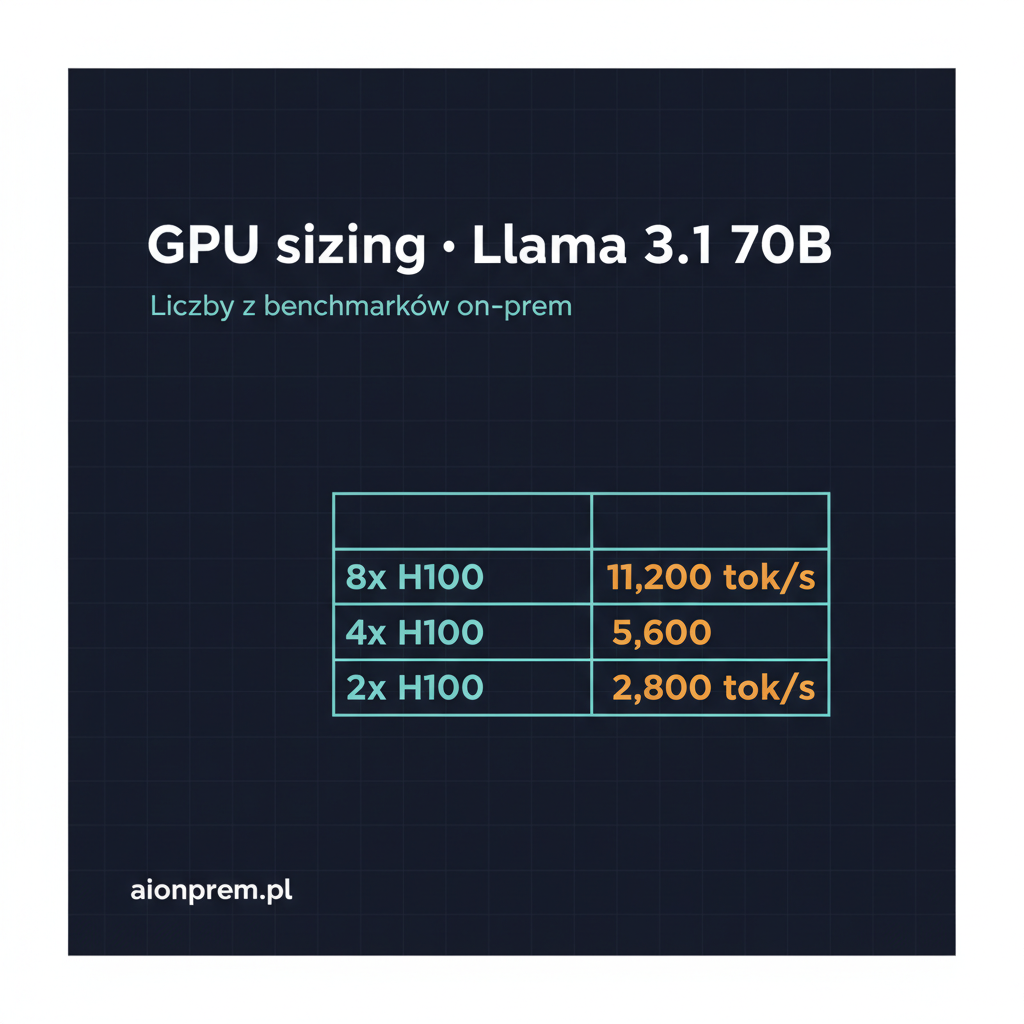
GPU sizing dla Llama 3.1 70B inference: liczby z benchmarków

Ile GPU realnie potrzeba, żeby postawić Llamę 3.1 70B u siebie? Konkretne konfiguracje (A100, H100, H200), wpływ kwantyzacji (FP16 → FP8 → INT4), tokens/s, TTFT i koszt per 1M tokenów. Bez marketingu, z liczbami z benchmarków vLLM i TensorRT-LLM.

Najczęstsze pytania
Czy reranker zawsze poprawia RAG?

Nie, pomaga przy dużych, zaszumionych korpusach; przy małych, dobrze pociętych zbiorach bywa zbędnym kosztem GPU i opóźnieniem.

vLLM czy Ollama na produkcję?

Do developmentu Ollama jest wygodna; na produkcję przy obciążeniu vLLM daje wielokrotnie wyższą przepustowość (batching, multi-GPU).

Ile VRAM potrzebuję?

Zależy od rozmiaru modelu i kwantyzacji, patrz artykuł o GPU sizing; z grubsza model w FP16 potrzebuje ~2× liczby parametrów w GB, plus zapas na kontekst.

Chcesz przełożyć to na swój przypadek: architekturę, zgodność i koszt?

→ Umów 30 min